「MacBook Air M4でローカルLLM(手元のPCで動かす大規模言語モデル)は実用になるのか」「メモリは16GBで足りるのか、24GB以上にすべきか」。ファンレスの薄型ノートということもあり、購入前に不安を感じている方は多いと思います。
この記事では、MacBook Air(M4・GPU 10コア・メモリ24GB・ファンなし)で11種類のローカルLLMを実測した結果をもとに、速度・必要メモリ・現実的な選び方を整理します。推測や伝聞ではなく、2026年11月14日に自分の機材で計測した数値を基準に解説します。
- MacBook Air M4(24GB)での日本語生成速度は、4Bクラスで約59字/秒、9Bクラスで約34字/秒
- 24GBモデルでGPUに割り当てられたメモリ上限は実測で18,186MiB(約19GB)
- モデルサイズと速度は比例せず、MoE構成の26Bが12Bの2.6倍速いケースもある
- 16GBで狙うなら「必要メモリ目安10GB以下」のモデルが現実的な線引き
- Q8_0はQ4_K_Mより約37%遅く、メモリも1.5倍必要になる
MacBook Air M4でローカルLLMは実用になるのか
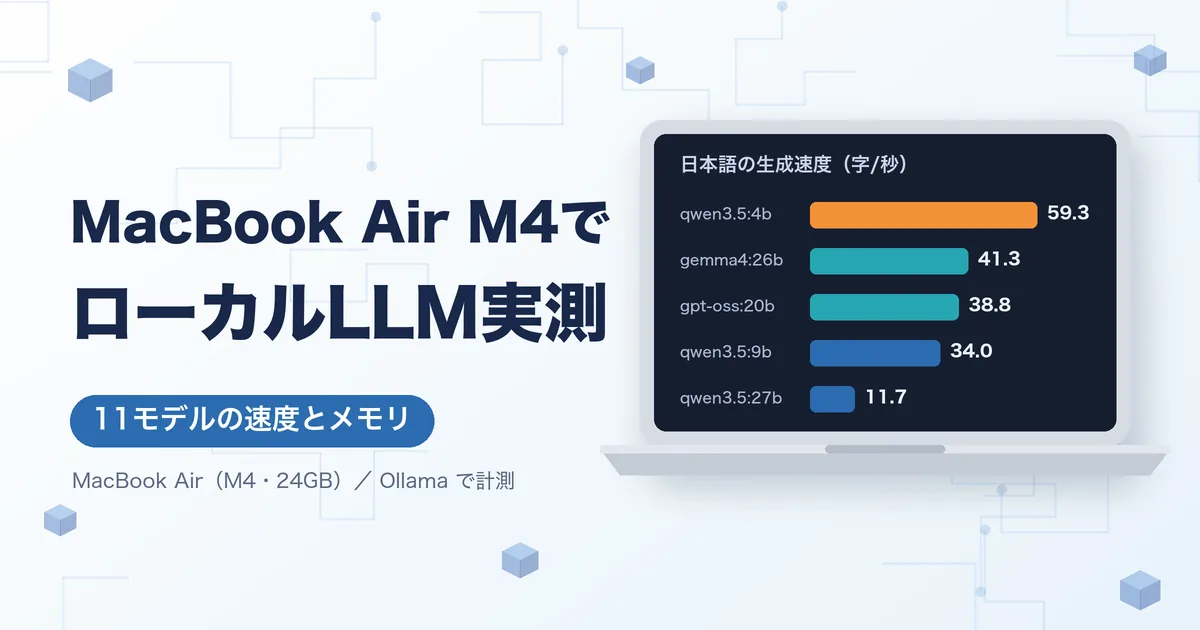
結論から書くと、チャットや文章の下書き、コード補助といった用途であれば十分に実用的です。実測では4Bクラスのモデルで日本語が毎秒約59文字、9Bクラスで約34文字出力されました。400字ほどの説明文なら、4Bクラスで約7秒、9Bクラスで約12秒で書き終わる計算です。
一方で、27Bクラスの非MoEモデルは11.7字/秒まで落ち込み、同じ400字に約34秒かかります。MacBook Air M4で無理なく動かせる上限は、メモリ容量とモデルの種類(MoEかどうか)で大きく変わる、というのが実測から見えた結論です。
測定条件
- 機材:MacBook Air(M4・GPU 10コア・メモリ24GB・ファンなし)
- 環境:macOS 27.2 / Ollama 0.32.6 / AC電源接続
- 生成設定:temperature 0・最大出力512トークン・コンテキスト8K、thinking(思考モード)はオフ(gpt-ossのみ無効化できないためlow)
- 計測方法:各モデル3回測定した中央値。モデルごとに60秒冷ましてから測定。他アプリは開いたまま
- 指標:「字/秒」は日本語で1秒間に出力された文字数。確認日は2026年11月14日
- モデルの入手先:Ollama公式ライブラリから取得(量子化はOllamaの標準版。MLX版と8bit版のみ別タグ)
他のアプリを閉じない状態で測っているため、クリーンな環境での最大値ではなく「普段使いに近い条件での数値」である点にご注意ください。
MacBook Air M4で実測したローカルLLM 11モデルの速度比較
以下が、同一条件で測定した11モデルの一覧です(日本語の説明文生成が速い順)。
| モデル | 量子化/規模 | 日本語 (字/秒) | コード (字/秒) | トークン/秒 | 必要メモリ 目安(8K) | DL容量 |
|---|---|---|---|---|---|---|
| qwen3.5:4b | Q4_K_M / 4.2B | 59.3 | 82.2 | 26.8 | 3.7GB | 3.3GB |
| gemma4:26b | Q4_K_M / 25.2B | 41.3 | 61.8 | 19.6 | 19.6GB | 18.7GB |
| gpt-oss:20b | MXFP4 / 20.9B | 38.8 | 65.1 | 24.8 | 14.0GB | 13.8GB |
| qwen2.5:7b | Q4_K_M / 7.6B | 37.8 | 62.6 | 22.2 | 5.3GB | 4.7GB |
| qwen3.5:9b | Q4_K_M / 9.0B | 34.0 | 56.8 | 15.3 | 7.0GB | 6.5GB |
| qwen3.5:9b-mlx | nvfp4 / 9.4B | 32.4 | 49.6 | 14.1 | 8.1GB | 8.9GB |
| llama3.1:8b | Q4_K_M / 8.0B | 32.1 | 51.9 | 20.2 | 5.8GB | 4.9GB |
| gemma4:e4b | Q4_K_M / 7.5B | 31.8 | 53.0 | 15.6 | 7.1GB | 6.6GB |
| qwen3.5:9b-q8_0 | Q8_0 / 9.0B | 21.8 | 39.2 | 9.7 | 10.7GB | 10.4GB |
| gemma4:12b | Q4_K_M / 11.9B | 15.7 | 23.6 | 7.5 | 9.0GB | 8.0GB |
| qwen3.5:27b | Q4_K_M / 26.9B | 11.7 | 13.7 | 5.4 | 18.1GB | 17.5GB |
(出典: 自分の機材での実測、2026年11月14日計測)
「字/秒」と「トークン/秒」がねじれる理由
表を見ると、トークン/秒ではqwen3.5:4b(26.8)とgpt-oss:20b(24.8)が近いのに、字/秒では59.3対38.8と大きな差が出ています。これはモデルごとに1トークンあたりの日本語文字数が違うためです。日本語で使う場合は、トークン/秒だけでなく字/秒で見たほうが体感に近くなります。
モデルサイズと速度は比例しない
実測で最も印象的だったのは、パラメータ数が約2倍のgemma4:26b(41.3字/秒)が、gemma4:12b(15.7字/秒)の2.6倍速かった点です。これはgemma4:26bがMoE(Mixture of Experts=複数の専門家モジュールの一部だけを使う構成)で、128の専門家のうち8つだけを動かすためです。同じくMoE構成のgpt-oss:20b(専門家32のうち4つ)も38.8字/秒と高速でした。
一方、非MoEのqwen3.5:27bは11.7字/秒。「何Bか」よりも「MoEかどうか」が、MacBook Air M4での体感速度を左右します。モデル選びの際は、パラメータ数だけで判断しないことをおすすめします。
長い文章を読ませたときの処理速度
約2,000字(約1,300トークン)のテキストを読み込ませた際の処理速度も測定しました。gpt-oss:20bが334.7トークン/秒と最速で、以下gemma4:26bが190.9、qwen2.5:7bが190.5、qwen3.5:9bが152.9。最も遅かったのはqwen3.5:27bの35.7トークン/秒でした。要約やRAG(検索した文書を読ませる使い方)のように長文を投入する用途では、生成速度だけでなくこの読み込み速度も効いてきます。
MacBook Air M4のメモリ16GB・24GBでローカルLLMをどう選ぶか
24GBでGPUに使えるのは約19GBまで
Apple Siliconはユニファイドメモリ(CPUとGPUが同じメモリを共有する仕組み)ですが、GPUが使える量には上限があります。24GBモデルでは、Ollamaのログ上の上限が18,186MiB(約19GB)と実測で確認できました。
この上限の影響は明確に出ました。必要メモリ14.0GBのgpt-oss:20bは全25層がGPUに載り38.8字/秒。対して必要メモリ18.1GBのqwen3.5:27bは65層のうち3層がGPUからあふれ、5.4トークン/秒(11.7字/秒)まで低下しました。Ollamaは余裕を残して配置するため、上限ぎりぎりではなく少し手前からあふれ始めます。
16GB構成で現実的に選べるモデル
今回の計測機は24GBのため、16GB機での直接計測はしていません。ただし、24GBで上限が約19GB(総容量の約74%)だった比率をそのまま当てはめると、16GBでは約12〜13GBがGPU割当の目安になります(あくまで比率からの試算です)。さらにOSや他アプリの使用分を考えると、実用的な上限はもう少し下がります。
この前提で、表の「必要メモリ目安」から16GB機での可否を整理すると次のようになります。
- 余裕を持って動く(〜6GB): qwen3.5:4b(3.7GB)、qwen2.5:7b(5.3GB)、llama3.1:8b(5.8GB)
- 動くが他アプリと取り合いになる(7〜9GB): qwen3.5:9b(7.0GB)、gemma4:e4b(7.1GB)、qwen3.5:9b-mlx(8.1GB)、gemma4:12b(9.0GB)
- 厳しい(10GB以上): qwen3.5:9b-q8_0(10.7GB)、gpt-oss:20b(14.0GB)、qwen3.5:27b(18.1GB)、gemma4:26b(19.6GB)
つまり16GBなら「4B〜9BクラスのQ4量子化」が主戦場で、20B超のMoEモデルを動かしたいなら24GB以上が必要という整理になります。実測で最速だったqwen3.5:4bは3.7GBしか使わないため、16GB機でも最も軽快に使える選択肢です。
コンテキスト長を伸ばすとメモリはどれだけ増えるか
コンテキスト(一度に扱える文章量)を4Kから32Kに広げたときの必要メモリの変化も測定しました。
| モデル | 4K | 32K | 増加 |
|---|---|---|---|
| qwen3.5:4b | 3.5GB | 4.2GB | +0.7GB |
| qwen2.5:7b | 5.0GB | 6.1GB | +1.2GB |
| llama3.1:8b | 5.3GB | 7.4GB | +2.1GB |
| qwen3.5:9b | 6.8GB | 7.3GB | +0.6GB |
| gemma4:e4b | 6.8GB | 7.6GB | +0.8GB |
| gemma4:12b | 8.6GB | 9.5GB | +0.8GB |
| qwen3.5:9b-q8_0 | 10.7GB | 11.2GB | +0.6GB |
| gpt-oss:20b | 14.0GB | 14.4GB | +0.4GB |
| qwen3.5:27b | 17.9GB | 19.0GB | +1.1GB |
| gemma4:26b | 19.5GB | 19.9GB | +0.5GB |
増加幅はモデルによって大きく異なり、llama3.1:8bは+2.1GBと目立つ一方、gpt-oss:20bは+0.4GB、gemma4:26bは+0.5GBで、5倍近い差がありました。注意すべきは上限付近のモデルで、qwen3.5:27bは32KにするとGPUに載る層が62→59へ減りました。容量ぎりぎりのモデルでコンテキストを広げると、速度が一段落ちるリスクがあります。
量子化とMLX版の選び方
Q4_K_MとQ8_0の差は約37%
同じqwen3.5:9bで量子化(モデルの数値精度を落として軽量化する処理)だけを変えて比較しました。
- Q4_K_M: 15.3トークン/秒・必要メモリ7.0GB
- Q8_0: 9.7トークン/秒・必要メモリ10.7GB
8bit版は約37%遅く、メモリは1.5倍という結果です。MacBook Air M4のメモリ容量を考えると、まずはQ4_K_Mから試し、品質に不満がある場合のみQ8_0や上位モデルを検討する順序が合理的です。
MLX版は必ずしも速いわけではない
Apple Silicon向けフレームワークMLXを使ったqwen3.5:9b-mlx(nvfp4量子化)は14.1トークン/秒で、通常のGGUF版Q4_K_M(15.3トークン/秒)をわずかに下回りました。ただし量子化方式が異なるため、これはMLX自体の性能差を示すものではありません。「MLX版なら必ず速い」と期待して乗り換えると、思ったほどの差が出ない可能性がある点は押さえておくとよいでしょう。
Gemma 4の高速化はドラフトモデルによるもの
Ollama 0.32系のGemma 4は、ログ上で--spec-type draft-mtpが確認でき、下書き役の小さなモデルと組み合わせて推測的に生成する仕組み(投機的デコード)が働いています。gemma4:26bが日本語の説明41.3字/秒に対しコード生成で61.8字/秒という「コードのほうが速い」傾向を示したのは、次の語が予測しやすい文章ほどこの仕組みが効くためと考えられます。
ファンレスのMacBook Air M4でローカルLLMを動かす際の注意点
初回ロードは最大25秒かかる
モデルを最初に読み込む時間も測定しました。9GBまでのモデルは2〜5秒(llama3.1:8bが1.68秒で最短)ですが、10GBを超えると12〜25秒に伸び、gemma4:26bは25.35秒、gpt-oss:20bは12.65秒でした。思いついたときにサッと聞く用途では、軽量モデルを常駐させておくほうが快適です。
大きいモデルではスワップが増える
他のアプリを開いたままの状態で、gpt-oss:20bで+2.8GB、gemma4:26bで+4.7GB、qwen3.5:27bで+1.9GBのスワップ(メモリ不足分をSSDに退避する処理)増加を確認しました。24GB機でも14GB超のモデルを使うなら、他のアプリを閉じてから起動したほうが安定します。
発熱については断定できなかった
ファンレス構成で気になる発熱ですが、今回の測定ではmacOSの熱に関する警告は一度も出ませんでした。gemma4:12bとqwen2.5:7bで3回目の計測だけ1〜2割遅くなる現象はありましたが、原因が熱によるものとは言い切れません。長時間の連続生成での挙動は今回の測定範囲外です。
MacBook Air M4でローカルLLMを始める手順
今回の測定で使ったOllamaは、MacBook Air M4で最も手軽な選択肢です。大まかな流れは次のとおりです。
- Ollama公式サイトからmacOS版をダウンロードしてインストール
- ターミナルで
ollama run qwen3.5:4bのように実行すると、モデルのダウンロードから対話開始まで自動で進む ollama psでメモリ使用量とGPUへの割り当て状況を確認する- 長文を扱うなら環境変数
OLLAMA_CONTEXT_LENGTHでコンテキスト長を調整する(指定しない場合は、GPUメモリの量に応じて4K・32K・256Kのいずれかになるとollama serve --helpに書かれています)
なおollama psが表示するGemma 4のメモリ値は誤りがあり、gemma4:e4bが0.29GBと表示されました(実際の必要メモリ目安は7.1GB)。Gemma系を使う場合、この表示はそのまま信用しないほうが安全です。
費用やスペック選定を含めた全体像から整理したい方は、ローカルLLM構築ガイド|費用・スペック・手順を徹底解説も合わせて確認すると判断しやすくなります。
用途別に見るMacBook Air M4向けローカルLLMの選び方
ここでの選び方は、今回測った速さとメモリだけを基準にしています。答えの正確さや日本語の自然さは比べていないので、候補を絞ったあとに自分の用途で試してみてください。
- とにかく速さ重視・16GBでも使いたい:qwen3.5:4b(59.3字/秒・必要メモリ3.7GB・DL 3.3GB)。11モデル中で最速かつ最軽量という扱いやすい組み合わせです。
- 速度と規模のバランス(24GB以上):gpt-oss:20b(38.8字/秒・14.0GB)。読み込み速度も334.7トークン/秒で最速のため、長文を投げる用途に向きます。
- 大きめのモデルを速く動かしたい(24GB、他アプリは閉じる):gemma4:26b(41.3字/秒・19.6GB)。MoE構成で25Bクラスながら高速で、コードは61.8字/秒でした。ただしスワップが+4.7GB増えた点は考慮が必要です。
- 9Bクラスで安定運用したい:qwen3.5:9b(34.0字/秒・7.0GB)。32Kに広げても+0.5GBで済み、16GB機でも選択肢に入ります。
今回の実測で確認できなかったこと
データの性質を正しく伝えるため、今回の測定範囲外の項目も明示します。
- 出力される日本語の品質は評価していません。速度とメモリのみの比較です
- バッテリー駆動時の挙動は未測定(AC電源接続での計測)
- 16GB・32GB構成での直接計測はしておらず、16GBの記述は必要メモリ目安からの試算です
- 長時間連続稼働時のサーマルスロットリング(熱による性能低下)は確認できていません
まとめ
MacBook Air M4(24GB)での実測から見えたポイントを整理します。
- 4Bクラスで59.3字/秒、9Bクラスで34.0字/秒。日常的なチャットや下書き用途では十分実用的
- 24GBでGPUに割り当てられる上限は実測18,186MiB(約19GB)。上限に近づくとGPUからあふれ、速度が大きく落ちる
- パラメータ数より構成が重要で、MoEのgemma4:26bは非MoEのgemma4:12bの2.6倍速い
- 16GB構成なら必要メモリ10GB以下、つまり4B〜9BクラスのQ4量子化が現実的な範囲(24GBでの比率からの試算)
- Q8_0はQ4_K_Mより約37%遅くメモリ1.5倍。まずQ4から試すのが効率的
「MacBook Air M4でローカルLLMは動くのか」という問いに対しては、モデルの選び方次第で十分に動くというのが実測に基づく答えです。特に16GB構成を検討している方は、動かしたいモデルの必要メモリを先に確認してから構成を決めると、後悔が少なくなります。