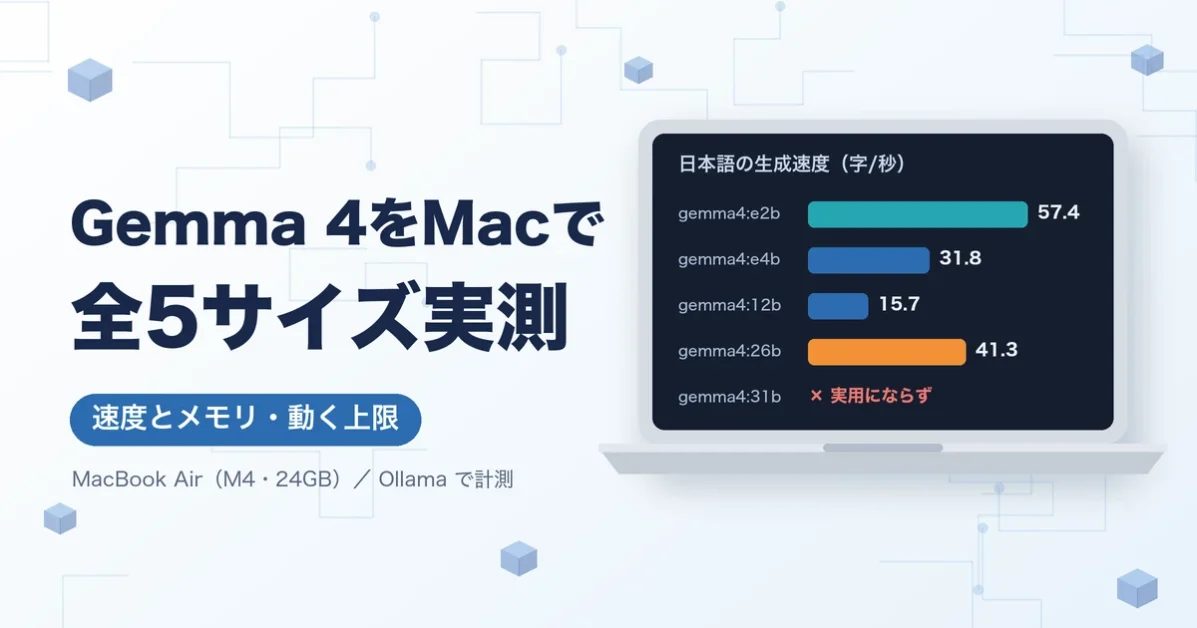
Googleのオープンモデル「Gemma 4」は、Apache 2.0ライセンスで配布され、Apple Silicon搭載のMacでもローカル実行できるモデルです。ただし公開サイズは E2B から 31B まで5種類あり、「自分のMacで現実的に動くのはどれなのか」が最大の悩みどころになります。
この記事では、2026年11月15日に確認した公式モデルカードとOllama公式ライブラリの情報を整理したうえで、筆者がMacBook Air M4(メモリ24GB)で5サイズすべてを実測した結果を公開します。カタログスペックではなく、実際に何字/秒で出力され、何GBのメモリを要求されたかという数字をもとに、Macでのサイズ選びを判断できるようにまとめました。
この記事のポイント
- Gemma 4は E2B / E4B / 12B / 26B A4B / 31B の5サイズ。26B A4BはMoE(専門家の混合)構成で、Macでは12Bより速いという逆転が起きる
- MacBook Air M4(24GB)での実測では、e2b 57.4字/秒、e4b 31.8字/秒、12b 15.7字/秒、26b 41.3字/秒、31bは毎秒0.08トークンで実用外
- 24GBのMacでGPUが使えるのは約19GB(Ollamaログ上18,186MiB)。31Bは全層GPU化に約18,957MiBが必要で収まらなかった
- Ollamaのダウンロード容量・コンテキスト長・量子化タグ(Q4_K_M / Q8_0 / QAT / MTP)を公式ライブラリの表記で整理
- Mac mini・Mac Studio・MacBook Air M5などは未検証。判断軸となる「メモリ容量」「GPUに載るか」の考え方を提示
Gemma 4をMacで動かす前に知っておきたい5サイズの違い
まずはモデル側の仕様を押さえます。以下は2026年11月15日に公式モデルカードで確認した内容です。
公式モデルカードで確認した5サイズのスペック
| サイズ | パラメータ | 層数 | コンテキスト | 入力 |
|---|---|---|---|---|
| E2B | 実効2.3B(埋め込み込み5.1B) | 35層 | 128K | テキスト/画像/音声 |
| E4B | 実効4.5B(同8B) | 42層 | 128K | テキスト/画像/音声 |
| 12B | 11.95B | 48層 | 256K | テキスト/画像/音声 |
| 26B A4B | 総25.2B / 実働3.8B(MoE) | 30層 | 256K | テキスト/画像 |
| 31B | 30.7B | 60層 | 256K | テキスト/画像 |
E2BとE4Bの「E」は実効パラメータ(Effective)の意味で、埋め込みを含めた数(5.1B・8B)より小さい値で呼ばれています。音声入力に対応するのはE2B・E4B・12Bの3つで、26B A4Bと31Bはテキストと画像のみです(公式モデルカード)。なお、Ollamaのライブラリではどのサイズも入力は「テキスト・画像」と表記されています。
26B A4BはMoEなので「大きいのに軽い」
Macでのサイズ選びを大きく変えるのが 26B A4B です。公式モデルカードによると、このモデルはMoE(Mixture of Experts/専門家の混合)構成で、128個の専門家のうち8つ+共有1つだけを使います。総パラメータは25.2Bですが、1トークンあたり実際に計算されるのは3.8B分だけです。
つまりメモリは25B級だが計算量は4B級という構成で、メモリに載りきれば小型モデル並みの速度が出る可能性があります。後述の実測でも、この特性がはっきり数字に出ました。
ライセンスはApache 2.0
Gemma 4のライセンスは、公式モデルカードおよびOllama公式ライブラリの表記でいずれも Apache 2.0 です(2026年11月15日確認)。商用利用を含めて扱いやすいオープンソースのライセンスです。
Gemma 4をMacで実測|MacBook Air M4(24GB)で5サイズを比較
測定条件
以下はすべて筆者が自分の機材で実測した記録です。条件は次のとおりです。
- 機材: MacBook Air(M4・GPU 10コア・メモリ24GB・ファンなし)
- OS / 実行環境: macOS 27.2、Ollama 0.32.6、AC電源接続
- 設定: temperature 0、出力最大512トークン、コンテキスト8K、思考(thinking)はオフ
- 各モデル3回測定した中央値。モデルごとに60秒冷却してから測定。他のアプリは開いたまま
- 「字/秒」は日本語の説明文を生成したときに1秒間に出力された文字数
- 測定日: e4b・12b・26bは2026年11月14日、e2bと31bは2026年11月15日
5サイズの速度・メモリ実測結果
| モデル(Q4_K_M) | 日本語説明 | コード生成 | 入力読込 | 初回ロード | DL容量 | 必要メモリ(8K) | GPU層 |
|---|---|---|---|---|---|---|---|
| gemma4:e2b | 57.4字/秒(28.0 tok/s) | 107.7字/秒 | 561.6 tok/s | 4.91秒 | 4.6GB | 5.0GB | 全層 |
| gemma4:e4b | 31.8字/秒(15.6 tok/s) | 53.0字/秒 | 263.8 tok/s | 3.13秒 | 6.6GB | 7.1GB | 43/43 |
| gemma4:12b | 15.7字/秒(7.5 tok/s) | 23.6字/秒 | 91.8 tok/s | 2.90秒 | 8.0GB | 9.0GB | 49/49 |
| gemma4:26b | 41.3字/秒(19.6 tok/s) | 61.8字/秒 | 190.9 tok/s | 25.35秒 | 18.7GB | 19.6GB | 31/31(6層は専門家の一部がCPU側) |
| gemma4:31b | 実用外(0.08 tok/s) | 未測定 | 0.6〜0.9 tok/s | ― | 20GB | ― | 46/61 |
注目すべきは26bが12bの2.6倍速いという逆転です。パラメータ総数は2倍以上なのに、1トークンあたり実際に動くのが3.8B分だけというMoE構成が効いています。入力の読み込み(約2,000字=約1,300トークン)も26bが190.9 tok/sで、12bの91.8 tok/sを上回りました。
一方で26bは必要メモリ19.6GB、初回ロード25.35秒と重く、24GBのMacではほぼ上限いっぱいです。測定中には約4.7GBのスワップ増加も観測しました。日常的に使うなら、e2b(5.0GB)やe4b(7.1GB)のほうが扱いやすいのが実情です。
なお、e2bの必要メモリ5.0GBのうち1.2GBは画像を読む部分が占めています。今回の測定では文字だけをやり取りしましたが、この部分も読み込まれていました。メモリを見積もるときは、この分も含めておくと安全です。
31Bは24GBのMacでは実用にならなかった
gemma4:31b(Q4_K_M・ダウンロード20GB)は、MacBook Air M4(24GB)では測定を完遂できませんでした。記録した事実は以下のとおりです。
- GPUに載ったのは61層中46層。残り15層はCPU側で処理
- 生成速度は毎秒0.08トークン(30分で138トークン)。入力読み込みも毎秒0.6〜0.9トークン
- 1回の回答が30分で終わらず、測定を打ち切り
- 全層をGPUに載せるには約18,957MiBが必要だが、使えるのは18,185MiB。約770MiB足りなかった
- Ollamaが約3.5GB(3,469MiB)の空きを残すように層を減らしたため、GPU側の使用は約14.7GBに抑えられた(Ollamaのログより)
- 測定後にスワップが約3.5GBに増加(読み込み時の空きメモリは12.3GB、他アプリは開いたまま)
参考として、同じようにGPUからはみ出した qwen3.5:27b(65層中62層)は5.4トークン/秒出ていました。3層のはみ出しなら使える速さが残った一方、15層がはみ出した31bは桁違いに遅くなりました(31bの測定ではスワップも増えていました)。31Bを使いたいなら、全層をGPUに載せられるメモリ容量が前提になります。
MacBook Air M4での11モデル比較の詳細はMacBook Air M4でローカルLLM実測|11モデル比較にまとめています。
MacのメモリごとにGemma 4のどのサイズを選ぶか
実測で得られた必要メモリをもとに、サイズ選びの目安を整理します。ここで実測したのはMacBook Air M4(24GB)のみなので、他の容量については必要メモリとOS・他アプリの消費分から逆算した目安としてお読みください。
| Macのメモリ | 現実的な選択 | 考え方 |
|---|---|---|
| 8GB | e2b(必要5.0GB)が候補 | OSと他アプリを考えると余裕は小さい。e4bの7.1GBはかなり厳しい |
| 16GB | e2b / e4b / 12b(必要9.0GB) | 12bまでは全層GPUに載る見込み。26bの19.6GBは不可 |
| 24GB | 26bまで(必要19.6GB) | 実測で26bは動作したが上限ギリギリ。31bは不可 |
| 32GB以上 | 31bも候補 | 全層GPU化に約18,957MiB必要という記録から、容量が増えれば収まる可能性が高い(未検証) |
Macでローカルモデルを動かすときの判断軸は、GPUコア数やチップ世代よりもまずユニファイドメモリの容量です。実測では、24GBのMacでGPUに割り当てられる上限はOllamaのログ上で18,186MiB(約19GB)でした。Ollamaは余裕を残して層を配置するため、この上限の少し手前から層のはみ出しが始まります。
自分のMacで動くモデルを事前に確認したい場合はローカルLLM必要スペック診断も活用できます。
コンテキストを伸ばすとメモリはどれだけ増えるか
Gemma 4は12B以上で256Kという長いコンテキストに対応しますが、長く設定すればメモリも増えます。コンテキストを4Kから32Kに変えたときの必要メモリの実測値は以下のとおりです。
| モデル | 4K | 32K |
|---|---|---|
| gemma4:e2b | 4.8GB | 5.3GB |
| gemma4:e4b | 6.8GB | 7.6GB |
| gemma4:12b | 8.6GB | 9.5GB |
| gemma4:26b | 19.5GB | 19.9GB |
増加幅は0.4〜0.9GBで、モデル本体の大きさに比べれば緩やかです。ただしメモリ上限付近で使っている場合、この数百MBがGPUからのはみ出しを引き起こします。実際に qwen3.5:27b は32KにするとGPUに載る層が62→59へ減りました。
MacでGemma 4を動かす手順(Ollama)
導入と実行
Apple SiliconのMacであれば、Ollamaを入れてコマンド1行で実行できます。
- Ollama公式サイトからmacOS版をダウンロードしてインストール
- ターミナルで
ollama run gemma4:e2bのようにタグを指定して実行 - サイズ指定なしの
ollama run gemma4は既定で e4b が入る(公式ライブラリ表記)
最初に試すなら、まず e2b か e4b で挙動を確認し、メモリに余裕があれば上のサイズへ進むのが無駄のない流れです。環境構築全体の考え方はローカルLLM構築ガイドも参考になります。
Ollamaのタグとダウンロード容量
2026年11月15日にOllama公式のタグ一覧で確認した容量です。
| サイズ | Q4_K_M | Q8_0 | QAT版 | コンテキスト |
|---|---|---|---|---|
| e2b | 4.6GB | 6.0GB | 4.3GB | 128K |
| e4b | 6.6GB | 9.0GB | 6.1GB | 128K |
| 12b | 8.0GB | 13GB | 7.2GB | 256K |
| 26b | 18GB | 28GB | 16GB | 256K |
| 31b | 20GB | 34GB | 19GB | 256K |
QAT(量子化を見込んで学習したモデル)版はQ4_K_Mよりさらに小さく、メモリが厳しいMacでは検討の余地があります。
MTP付きタグ(投機的デコーディング)について
タグ一覧には 26b-a4b-it-mtp-q4_K_M(19GB)のようにMTP付きのものがあります。公式ドキュメントによると、MTPは投機的デコーディング(小さな下書き役が先の数トークンを提案し、本体がまとめて検証する仕組み)のためのもので、出力の質は通常の生成と同じとされています。公式には具体的な高速化率の数値は示されていません。
また26B A4Bについては「バッチサイズ1では処理の重なりが限られるため、並列性の低いハードウェアでは速くならないことがある」という注意書きがあります。1人でMacから使う典型的な用途は、まさにバッチサイズ1です。MTPを前提に速度を期待しすぎないほうが安全と言えます。
なお筆者の環境では、Ollama 0.32系でGemma 4を動かすとログに --spec-type draft-mtp が現れ、下書き役のモデルが併せて読み込まれていました(31bでは5層の下書き役を確認)。前述の26bの41.3字/秒という結果については、MoE構成という明確な理由があるため、MTPの効果と断定はしていません。
Gemma 4と他のローカルLLMをMacで比較
同じMacBook Air M4(24GB)・同条件で測った他モデルと並べると、Gemma 4の位置づけが見えてきます。
| モデル | 日本語説明 | 必要メモリ(8K) | 初回ロード | GPU層 |
|---|---|---|---|---|
| qwen3.5:4b | 59.3字/秒 | 3.7GB | 3.50秒 | 33/33 |
| gemma4:e2b | 57.4字/秒 | 5.0GB | 4.91秒 | 全層 |
| gemma4:26b | 41.3字/秒 | 19.6GB | 25.35秒 | 31/31 |
| gpt-oss:20b | 38.8字/秒 | 14.0GB | 12.65秒 | 25/25 |
| qwen2.5:7b | 37.8字/秒 | 5.3GB | 4.76秒 | 29/29 |
| qwen3.5:9b | 34.0字/秒 | 7.0GB | 3.25秒 | 33/33 |
| llama3.1:8b | 32.1字/秒 | 5.8GB | 1.68秒 | 33/33 |
| gemma4:e4b | 31.8字/秒 | 7.1GB | 3.13秒 | 43/43 |
| gemma4:12b | 15.7字/秒 | 9.0GB | 2.90秒 | 49/49 |
| qwen3.5:27b | 11.7字/秒 | 18.1GB | 15.68秒 | 62/65 |
上位はMoE構成のモデル(gemma4:26b、gpt-oss:20b)と小型モデルが占めています。密なモデル(dense)である gemma4:12b や qwen3.5:27b は、パラメータ数がそのまま速度の重さとして表れました。今回の測定では、「パラメータ数の大きさ」より「1トークンあたり動くパラメータ数」が速さを決めていました。
なお、出力される日本語の品質は今回の測定では評価していません。速度とメモリだけで優劣を判断しないようご注意ください。
量子化とMLX版の違い
qwen3.5:9bで量子化の違いを比べた記録は次のとおりです。
- Q4_K_M: 15.3トークン/秒・必要メモリ7.0GB
- Q8_0: 9.7トークン/秒・必要メモリ10.7GB(Q4比で約37%遅い)
- MLX版(nvfp4): 14.1トークン/秒・必要メモリ8.1GB(Ollama表示値)
8bit量子化は品質面で有利とされますが、速度とメモリの代償は小さくありません。Gemma 4でもQ8_0のダウンロード容量はQ4_K_Mの1.3〜1.7倍(サイズが大きいほど差が開く)になるため、Macでは基本的にQ4_K_MかQAT版から始めるのが現実的です。MLX版と通常版(GGUF)の差は量子化方式が異なるため、MLXそのものの優劣とは言えません。
MacでGemma 4を動かすときの注意点
実測の過程で確認できた、カタログに出てこない挙動をまとめます。
- 全層がGPUに載らないと、極端に遅くなることがある:24GBのMacでGPUが使えるのは約19GBです。15層がはみ出した31bは毎秒0.08トークンまで落ちました。
- 大きいモデルではスワップが増える:他のアプリを開いたままの測定で、gpt-oss:20bは+2.8GB、gemma4:26bは+4.7GB、qwen3.5:27bは+1.9GBのスワップ増加を観測しました。大きいモデルを使うときは、ほかのアプリを閉じておくと余裕が出ます。
- 初回ロードは10GBを超えると長くなる:9GBまでのモデルは2〜5秒、10GBを超えると12〜25秒かかりました。gemma4:26bの25.35秒が最長です。
- ollama ps のメモリ表示は信用できない:Gemma 4について
ollama psが誤った値を返すケースがありました(e4bが0.29GBと表示)。メモリの確認はOllamaのログ側を見るのが確実です。 - ファンレスのMacBook Airでも熱の警告は出なかった:今回の測定(512トークン×3回、60秒冷却あり)では、macOSの熱に関する警告は一度も出ませんでした。ただしgemma4:12bとqwen2.5:7bは3回目だけ1〜2割遅くなっており、これが熱によるものとは断定できません。長時間の連続生成では条件が変わる可能性があります。
よくある質問
まとめ
Gemma 4をMacで動かす際の結論を整理します。
- 常用するならe2bかe4b: e2bは57.4字/秒・必要メモリ5.0GBで、8GBのMacでも選択肢に入ります
- 24GBのMacなら26b(MoE)が最大の狙い目: 41.3字/秒で12bの2.6倍。ただし19.6GBでメモリは上限ギリギリ、初回ロード25秒、スワップ+4.7GBという代償があります
- 12bは速度面で不利: 15.7字/秒。品質を比較していないため一概には言えませんが、速度だけ見ればe4bや26bに劣ります
- 31bは24GBでは成立しない: 全層GPU化に必要な約18,957MiBに約770MiB足りず、毎秒0.08トークンまで落ちました
- 判断軸はメモリ容量と「GPUに全層載るか」: 全層が載らないと、31bのように極端に遅くなることがあります
Gemma 4はApache 2.0ライセンスで、音声入力(E2B・E4B・12B)や最大256Kのコンテキストにも対応した使いやすいモデル群です。まずは軽いサイズで自分のMacでの挙動を確かめ、必要メモリの実測値を基準に上のサイズへ進めていくのが、遠回りのない進め方だと言えます。
※本記事の実測値はMacBook Air(M4・GPU 10コア・メモリ24GB)、macOS 27.2、Ollama 0.32.6での測定結果です。仕様情報は2026年11月15日時点の公式モデルカードおよびOllama公式ライブラリに基づきます。