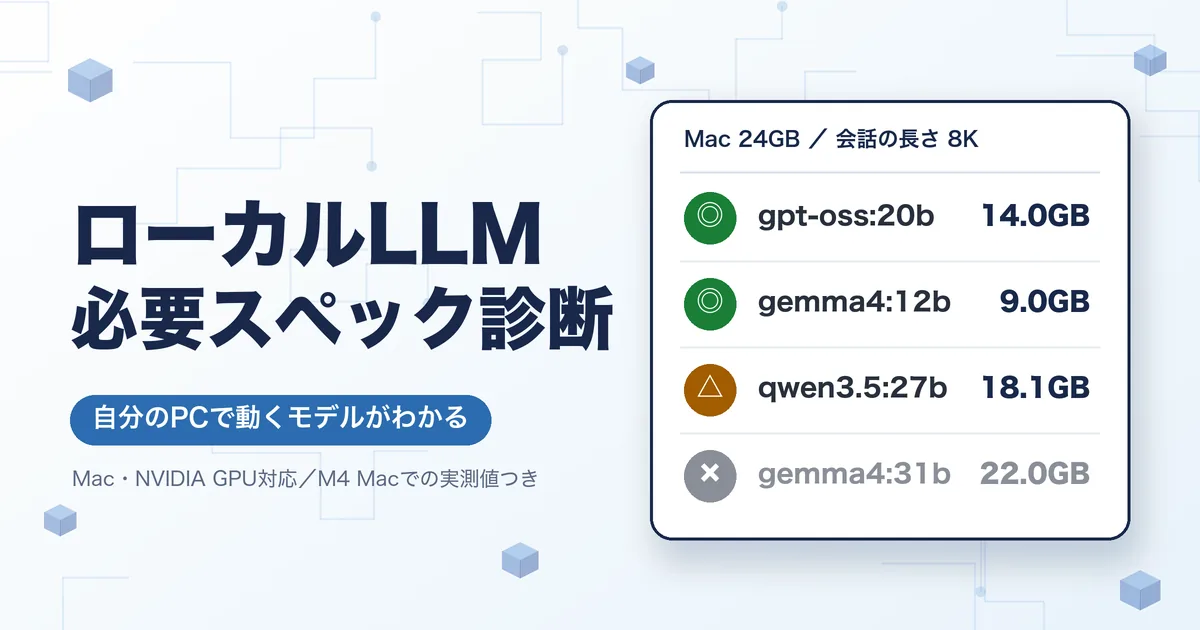
「自分のPCでローカルLLMは動く?」「どのモデルまでなら載る?」を調べるための診断ツールです。PCの種類とメモリ量、会話の長さを選ぶと、モデルごとの必要メモリと、GPUに全部載るか(◎)、はみ出すが動くか(△)、足りないか(✕)の目安が表示されます。
中身の数字は、2026年11月にMacBook Air M4(メモリ24GB)とOllamaで実際に測った値と、Ollama公式ライブラリのダウンロード容量をもとにしています。
- Macはメモリ量、NVIDIA GPUはVRAMとメインメモリを選ぶだけで診断できる
- 必要メモリは実測値(12モデル)と、公式のダウンロード容量からの推定値(5モデル)
- 24GBのMacでGPUに使えるのは約19GB(実測)。この割合をほかの容量にも当てはめている
- 会話の長さ(コンテキスト)を伸ばしたときのメモリの増え方も反映
ローカルLLM必要スペック診断ツール
ローカルLLM 必要スペック診断
◎ 全部GPUに載る△ はみ出すが動く(遅い)✕ 足りない
数字は必要メモリの目安(4bit量子化・Ollama)。「実測」は2026年11月14〜15日にMacBook Air M4(24GB)で測った値、「推定」は公式のダウンロード容量と同じ系統の実測から出した値です。
診断結果の見方
- ◎ 全部GPUに載る:モデル全体がGPU側のメモリに収まる。このPCでいちばん速く動く状態
- △ はみ出すが動く:GPUに収まりきらない分をCPU側(NVIDIAならメインメモリ)で動かす。動くが、はっきり遅くなる
- ✕ 足りない:メモリ全体でも足りない見込み。もっと小さいモデルか、短い会話の長さを選ぶ
例えば24GBのMacBook Air M4で実測したところ、全部GPUに載ったgpt-oss:20bは毎秒約39字でしたが、はみ出したqwen3.5:27bは毎秒約12字まで落ちました。一方、同じくはみ出したgemma4:26bは、一部の専門家だけを使うMoE型のため毎秒約41字出ています。△でも、MoE型なら実用的な速さになることがあります。
ただし、はみ出す量が大きいと、動いても実用になりません。gemma4:31b(必要約21.7GB)はGPUに61層中46層しか載らず、生成は毎秒0.08トークンで、1回の回答が30分たっても終わりませんでした。このツールでも、24GBのMacでは✕にしています。
モデル別の必要メモリ一覧
ツールと同じ数字を表にまとめました(4bit量子化。8bit版は表記のあるものだけ)。速さはMacBook Air M4(24GB)で日本語の説明文を書かせたときの実測値です。
| モデル | 必要メモリ(8K) | 必要メモリ(32K) | 日本語の速さ(M4実測) | 数字の種類 |
|---|---|---|---|---|
| qwen3.5:2b | 3.3GB | 3.9GB | — | 推定 |
| qwen3.5:4b | 3.7GB | 4.2GB | 毎秒59.3字 | 実測 |
| gemma4:e2b | 5.0GB | 5.3GB | 毎秒57.4字 | 実測 |
| qwen2.5:7b(旧世代) | 5.3GB | 6.1GB | 毎秒37.8字 | 実測 |
| llama3.1:8b(2024年の定番) | 5.8GB | 7.4GB | 毎秒32.1字 | 実測 |
| qwen3.5:9b | 7.0GB | 7.3GB | 毎秒34.0字 | 実測 |
| gemma4:e4b | 7.1GB | 7.6GB | 毎秒31.8字 | 実測 |
| gemma4:12b | 9.0GB | 9.5GB | 毎秒15.7字 | 実測 |
| qwen3.5:9b-q8_0(8bit版) | 10.7GB | 11.2GB | 毎秒21.8字 | 実測 |
| gpt-oss:20b(MoE) | 14.0GB | 14.4GB | 毎秒38.8字 | 実測 |
| qwen3.5:27b | 18.1GB | 19.0GB | 毎秒11.7字 | 実測 |
| gemma4:26b(MoE) | 19.6GB | 19.9GB | 毎秒41.3字 | 実測 |
| gemma4:31b | 21.7GB | 22.5GB | 実用にならず(毎秒0.08トークン) | 8Kは実測・32Kは推定 |
| qwen3.5:35b | 23.7GB | 24.6GB | — | 推定 |
| llama3.1:70b(2024年の定番) | 46.9GB | 51.1GB | — | 推定 |
| gpt-oss:120b(MoE) | 68.5GB | 69.1GB | — | 推定 |
| qwen3.5:122b | 85.6GB | 86.5GB | — | 推定 |
判定のしかた
必要メモリの計算式
必要メモリは「ダウンロード容量+会話の記憶(KVキャッシュ)+作業用のメモリ」で出しています。後ろの2つは、実測したときのOllamaのログに書かれた確保量です。画像を読むための部品や、Gemma 4の下書き役のモデルもダウンロード容量に含まれます。
GPUに使えるメモリの量
MacはCPUとGPUがメモリを共有しますが、GPUが使えるのは一部です。24GBのMacBook Air M4では、Ollamaのログ上の上限が18,186MiB(約19GB)で、搭載量の約74%でした。ほかの容量のMacには、この割合を当てはめています(実測ではなく推定です)。
GPUからはみ出す場合は、必要メモリがメモリ全体(Macは搭載量、NVIDIA GPUはVRAMとメインメモリの合計)より5GB以上少なければ△、そうでなければ✕にしています(OSやほかのアプリが使う分)。24GBのMacで、必要約21.7GBのgemma4:31bが実用にならなかったことから決めた目安です。
また、Ollamaはメモリを使い切らず、1.5〜3.5GBほど余裕を残してモデルを載せます(ログで確認)。そのため、必要メモリにMacは2GB、NVIDIA GPUは1.5GBを足して判定しています。
実測と推定の違い
- 実測:MacBook Air M4(24GB)で実際に動かし、Ollamaのログから読んだ必要メモリ。gemma4:31bは8Kだけ測れたので、ほかの長さは同じ系統のgemma4:12bの増え方から推定した値
- 推定:公式ライブラリのダウンロード容量に、同じ系統のモデルで測ったKVキャッシュと作業用メモリを足し、安全側にダウンロード容量の5%(最低0.3GB)を上乗せした値。llama3.1:70bのKVキャッシュは、公開されている構成から計算(同じ式で8bの実測値と一致することを確認)
- NVIDIA GPU:今回は測っていないため、VRAMとメインメモリの量だけで判定した目安
メモリが足りないときの選び方
- MoE型を選ぶ:同じ大きさでも速い。24GBのMacでgemma4:26bはgemma4:12bの2.6倍速かった
- 8bit版より4bit版:qwen3.5:9bで8bit版は約4割遅く、必要メモリは7.0GBから10.7GBに増えた
- 会話の長さを短くする:4Kから32Kに伸ばすと、llama3.1:8bは+2.1GB増えた(gpt-oss:20bは+0.4GB)
- ほかのアプリを閉じる:大きいモデルではスワップ(メモリの代わりにSSDを使う動き)が数GB増えた
よくある質問
まとめ
ローカルLLMが動くかどうかは、モデルの「何B」よりも、必要メモリがGPUに収まるかで大きく変わります。まず診断ツールで候補を絞り、◎のモデルから試すのが近道です。
- 必要メモリ=ダウンロード容量+会話の記憶+作業用メモリ
- 24GBのMacでGPUに使えるのは約19GB(実測)。全部載るとき(◎)がいちばん速い
- △でもMoE型なら実用的な速さになることがある(gemma4:26bで毎秒約41字)
- 足りないときは、MoE型・4bit版・短い会話の長さを選ぶ
構築の手順や費用はローカルLLM構築ガイド、11モデルの測定の詳細はMacBook Air M4でローカルLLM実測|11モデル比較をご覧ください。